페이지 불러오는 중
데이터베이스와 SQL
1. 데이터베이스란?
데이터베이스(DB)는 여러 시스템이나 사용자가 공유하고 사용할 목적으로 통합하여 관리되는 데이터의 집합입니다. 단순히 데이터를 모아두는 것을 넘어, 데이터의 중복을 최소화하고 무결성을 유지하며, 다수의 트랜잭션이 동시에 발생하더라도 데이터를 안전하게 처리(동시성 제어)할 수 있도록 설계된 시스템 기반입니다.
1) 트랙잰션
데이터베이스의 상태를 변화시키기 위해 수행하는 하나의 논리적인 작업 단위입니다.
즉, 트랜잭션이란 "전부 다 완벽하게 성공하거나, 아니면 아예 처음부터 없던 일로 되돌리거나(All or Nothing) 둘 중 하나만 허용하는 최소한의 업무 단위"라고 할 수 있습니다.
2) ACID (”데이터의 무.결.성.을 유지하는 데이터베이스 성질”)
- 원자성 (Atomicity) 트랜잭션에 포함된 작업들은 "모두 성공(All)" 하거나 "모두 실패(Nothing)" 해야 합니다. 부분적으로만 실행되는 일은 없습니다.
- 일관성 (Consistency) 트랜잭션 작업 처리의 결과가 항상 일관성 있는 데이터베이스 상태를 유지해야 합니다. (예: 무결성 제약 조건 만족)
- 고립성 / 격리성 (Isolation) 둘 이상의 트랜잭션이 동시에 실행될 때, 어떤 트랜잭션도 다른 트랜잭션의 연산에 끼어들 수 없습니다. 서로의 작업 내역을 중간에 볼 수 없습니다.
- 지속성 (Durability) 성공적으로 완료(Commit)된 트랜잭션의 결과는 시스템 장애가 발생하더라도 영구적으로 데이터베이스에 반영되어야 합니다.
2. RDBMS, SQL 란?
1) RDBMS (Relational Database Management System)란?
관계형 데이터베이스 관리 시스템으로, 데이터를 2차원 테이블(행과 열) 형태로 저장하고 관리합니다. 각 테이블은 고유한 기본 키(Primary Key)를 가지며, 외래 키(Foreign Key)를 통해 테이블 간의 관계(Relation)를 정의합니다. 엄격한 스키마를 준수하며 트랜잭션의 ACID(원자성, 일관성, 고립성, 지속성) 속성을 보장하는 것이 핵심입니다.
2) SQL (Structured Query Language)이란?
RDBMS에서 데이터를 정의(DDL), 조작(DML), 제어(DCL)하기 위해 사용하는 표준 언어입니다.
3) 대표적인 SQL 의 종류?
Oracle, MySQL, PostgreSQL 등이 있으며, 최대 장점은 데이터의 무결성과 정합성 보장입니다. 복잡한 비즈니스 로직이나 금융 거래 등 데이터의 정확성이 최우선인 시스템에 필수적입니다. 또한, 표준화된 쿼리 언어를 통해 복잡한 데이터 조인(Join)과 집계 처리가 가능합니다.
3. SQL(RDBMS)의 대표적인 종류와 특징
(참고: MySQL, Oracle 등은 정확히는 RDBMS 제품명이며, 이 제품들이 사용하는 SQL 방언(Dialect)이 조금씩 다릅니다.)
1) SQL(RDBMS) 종류가 구분되는 이유
ANSI SQL이라는 국제 표준이 존재하지만, 각 벤더사(Oracle, MS 등)가 ‘자사 DB 엔진의 성능 최적화와 고유 기능을 지원’하기 위해 표준을 확장한 독자적인 문법과 절차적 언어(예: Oracle의 PL/SQL, MS의 T-SQL)를 개발했기 때문입니다.
2) RDBMS의 특징
4. 빅데이터 시대와 NoSQL
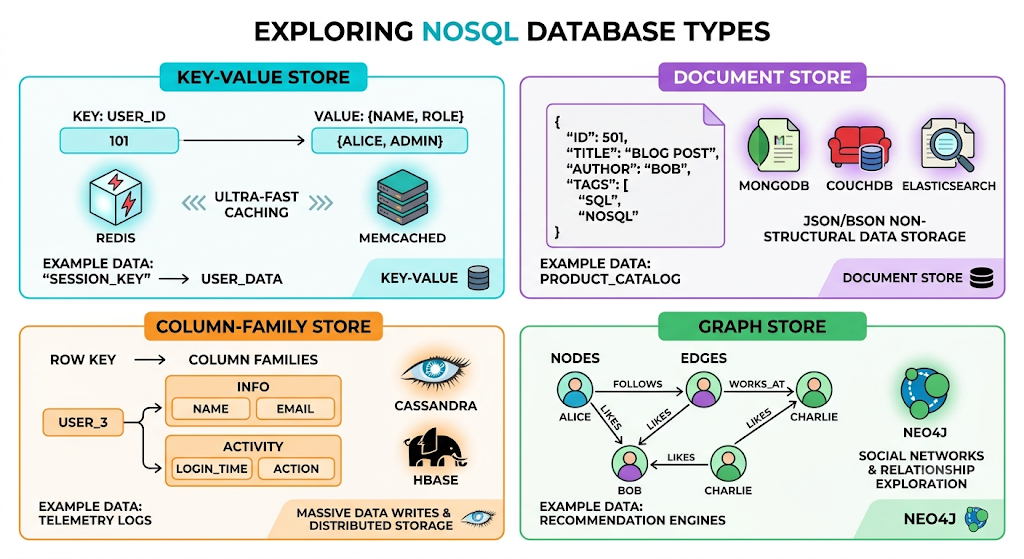
1) NoSQL의 종류와 대표적인 언어(데이터 모델)
NoSQL은 'Not Only SQL'의 약자로, 스키마가 없거나 유연하며 대용량 데이터의 분산 처리와 확장성에 특화되어 있습니다. SQL 대신 각자의 API 명령어를 사용합니다.
- Key-Value Store Redis, Memcached (초고속 캐싱)
- Document Store MongoDB, CouchDB, Elasticsearch (JSON 형태의 비정형 데이터 저장)
- Column-Family Store Cassandra, HBase (대규모 데이터 쓰기와 분산 저장)
- Graph Store: Neo4j (소셜 네트워크 등 노드 간의 관계 탐색)
2) Document 베이스인 Elasticsearch란?
Elasticsearch는 Apache Lucene 기반의 분산형 RESTful 검색 및 분석 엔진입니다. 기본적으로 JSON 형태의 Document를 저장하므로 Document DB로 분류되기도 합니다. 단순한 데이터 저장을 넘어 텍스트 전체에 대한 '전문 검색(Full-text Search)' 기능에 특화되어 있습니다.
3) Elasticsearch 활용 시 좋은 점/특이점
- 역색인(Inverted Index) 구조 특정 단어가 어느 문서에 포함되어 있는지 색인화하여, 방대한 데이터 속에서도 특정 키워드를 매우 빠르게 검색할 수 있습니다. (RDBMS의 B-Tree 인덱스로는 한계가 있는 LIKE 검색 등의 속도 문제 해결)
- 분산 처리 및 확장성 클러스터링을 통해 샤드(Shard)와 레플리카(Replica) 단위로 데이터를 분산 저장하므로 스케일 아웃(Scale-out)이 매우 용이합니다.
- 실시간에 가까운(Near Real-Time) 검색 데이터 색인 후 1초 내외로 검색이 가능합니다. 보통 Logstash, Kibana와 함께 ELK 스택으로 구성되어 애플리케이션 로그, 시스템 메트릭 모니터링 등에 강력한 시각화와 분석 기능을 제공합니다.
댓글
GitHub 계정으로 의견이나 질문을 남길 수 있습니다.