페이지 불러오는 중
Join과 실무에서의 인덱스 관리 (추가개념: 정규화/비정규화)
1. JOIN문이란?
1) JOIN의 종류
2) 각 JOIN의 예시
조인의 결과를 시각적으로 이해하기 위해, 다음과 같은 샘플 데이터를 가진 nano 테이블과 banana 테이블이 존재한다고 가정합니다.
-
nano테이블 (좌측)
-
banana테이블 (우측)
- INNER JOINSQL
text
SELECT n.tech_name, b.brand FROM nano n INNER JOIN banana b ON n.banana_code = b.banana_code;- 결과: 양쪽에 모두 존재하는
B01,B02데이터만 결합됩니다.
- LEFT JOINSQL
text
SELECT n.tech_name, b.brand FROM nano n LEFT JOIN banana b ON n.banana_code = b.banana_code;- 결과: 왼쪽
nano테이블은 무조건 다 나오고, 매핑 안 되는Robot-Nano는 우측 값이 NULL로 채워집니다.
- RIGHT JOINSQL
text
SELECT n.tech_name, b.brand FROM nano n RIGHT JOIN banana b ON n.banana_code = b.banana_code;- 결과: 오른쪽
banana테이블이 기준이 되므로, 매핑 안 되는DelMonte가 포함되고 좌측은 NULL이 됩니다.
- FULL OUTER JOIN (MySQL은 UNION으로 대체)SQL
text
-- Oracle/PostgreSQL 기준 문법
SELECT n.tech_name, b.brand FROM nano n FULL OUTER JOIN banana b ON n.banana_code = b.banana_code;- 결과: 매칭 여부와 상관없이 양쪽 테이블의 모든 행이 합집합 형태로 결합됩니다.
- CROSS JOINSQL
text
SELECT n.tech_name, b.brand FROM nano n CROSS JOIN banana b;- 결과: 조건 없이 모든 조합을 만듭니다. ($3 \times 3 = 9$개의 행 생성)
- SELF JOINSQL
text
-- banana 테이블 내에 상위 바나나(parent_code) 개념이 있다고 가정한 쿼리
SELECT b1.brand AS 하위바나나, b2.brand AS 상위바나나
FROM banana b1 JOIN banana b2 ON b1.parent_code = b2.banana_code;- NATURAL JOINSQL
text
-- 두 테이블에 공통으로 존재하는 'banana_code' 컬럼을 알아서 찾아서 조인
SELECT tech_name, brand FROM nano NATURAL JOIN banana;- LATERAL JOINSQL
text
-- 각 nano 행별로 우측 서브쿼리(최고가 banana 가격 계산 등)를 동적으로 호출하여 결합
SELECT n.tech_name, b_sub.brand
FROM nano n, LATERAL (SELECT * FROM banana b WHERE b.banana_code = n.banana_code) b_sub;
3) 도식화 (nano, banana 데이터 기준)
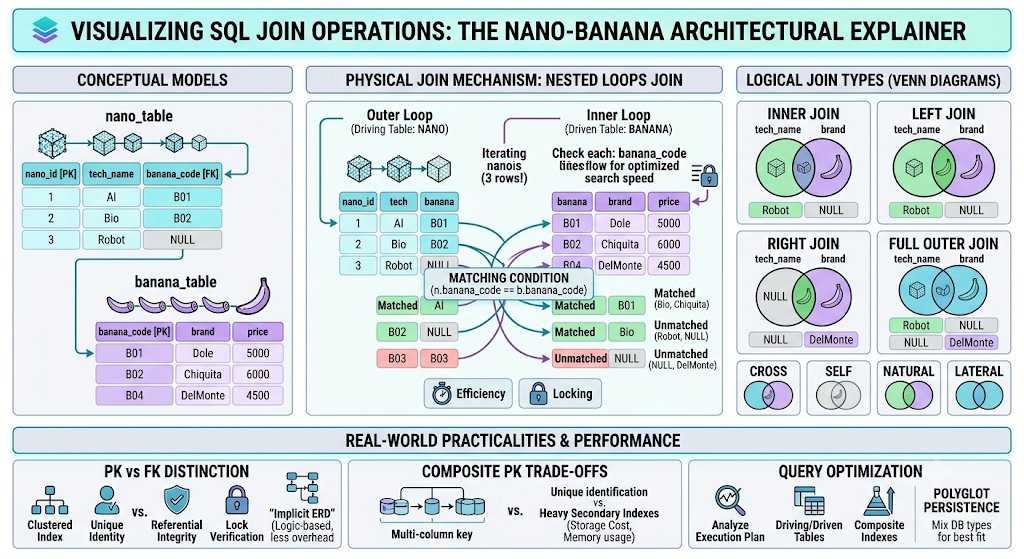
2. JOIN문도 인덱스(Index)의 영향을 받는다
1) JOIN문을 작성할 때 고려해야 하는 인덱스 메커니즘
실무에서 대다수의 RDBMS가 조인을 처리할 때 사용하는 기본 알고리즘은 Nested Loops Join(중첩 루프 조인)입니다. 이는 자바의 이중 for문과 유사하게 작동합니다.
sql
for(Row nano : nano_table) {         // 1. 외부에 노출된 드라이빙 테이블
    for(Row banana : banana_table) { // 2. 내부에서 맞춰보는 드리븐 테이블
        if(nano.code == banana.code) { 결합; }
    }
}- 드라이빙 테이블(Driving Table) 선역
조인을 시작할 때 먼저 읽는 기준 테이블입니다.
WHERE조건에 의해 필터링되어 최종 결과 행의 수가 더 적은 테이블이 드라이빙 테이블로 선택되어야 이중 루프의 바깥쪽 횟수가 줄어듭니다. - 드리븐 테이블(Driven Table)의 인덱스 필수성
바깥 루프가 돌 때마다 내부 루프(드리븐 테이블)를 풀 스캔하면 시스템이 마비됩니다. 따라서 조인 조건 절(
ON n.banana_code = b.banana_code)에서 드리븐 테이블 쪽 컬럼(b.banana_code)에는 반드시 인덱스가 생성되어 있어야 합니다. 인덱스가 있어야만 바깥에서 던져주는 키 값을 받아 $O(1)$ 또는 $O(\log N)$으로 즉시 데이터를 찾아 엮을 수 있습니다.
3. 실무에서는 인덱스를 어떻게 사용할까
1) PK(Primary Key)와 FK(Foreign Key) 선언의 차이점
- PK (기본 키): 테이블에서 행의 고유성을 보장하는 식별자입니다. MySQL InnoDB 엔진 기준으로 PK를 선언하면 물리적으로 데이터가 정렬되는 클러스터형 인덱스(Clustered Index)가 자동으로 생성되므로, PK를 통한 조회 속도는 최상 수준입니다.
- FK (외래 키): 참조 무결성을 지키기 위해 두 테이블 간의 관계를 맺어주는 제약조건입니다. 부모 테이블의 데이터가 지워지거나 바뀔 때 자식 데이터가 정해진 규칙(Cascade 등)을 따르도록 물리적 락(Lock) 검증을 동반합니다. MySQL의 경우 FK를 지정하면 해당 컬럼에 인덱스가 자동 생성되지만, Oracle 등 일부 DB는 자동 생성되지 않아 개발자가 직접 수동 인덱스를 추가해 주어야 조인 성능 병목과 테이블 락 누적을 막을 수 있습니다.
2) PK의 복합화(Composite PK)로 인해 얻어지는 장점과 단점
두 개 이상의 컬럼을 묶어서 하나의 PK로 지정하는 방식입니다.
-
장점: * 비즈니스적 관계성(예:
주문번호 + 상품순번) 자체를 물리적 유일성으로 강제할 수 있어 데이터 정합성이 완벽해집니다. -
복합키로 지정된 순서대로 정렬 인덱스가 빌드되므로, 해당 컬럼들이 동시에
WHERE절에 조건으로 들어오는 다중 조건 쿼리의 조회 속도가 극대화됩니다. - 단점:
-
인덱스 크기 비대화: InnoDB 구조상 모든 보조 인덱스(Secondary Index)들은 실제 데이터의 위치 주소 대신 PK 값을 주소록으로 품고 있습니다. 따라서 PK가 복합키로 인해 무거워지면 해당 테이블에 생성되는 다른 모든 보조 인덱스의 크기도 함께 커져 버퍼 풀(Buffer Pool) 메모리를 과도하게 낭비하게 됩니다.
-
유지보수성 저하: JPA 같은 ORM 프레임워크를 다룰 때 복합키를 처리하기 위해 별도의 식별자 클래스(
@IdClass또는@EmbeddedId)를 계속 선언해 주어야 하므로 개발 공수와 코드가 복잡해집니다.
3) 묵시적 ERD 구조 (Implicit ERD)
실무 대규모 트래픽 환경이나 현대적인 마이크로서비스 아키텍처(MSA)에서는 데이터베이스 스키마 상에 물리적인 FK 제약조건을 명시적으로 선언하지 않는 경우가 대다수입니다. 설계도(ERD) 상에는 선으로 관계가 연결되어 있지만, 실제 DB를 조회해 보면 외래 키 제약조건이 한 개도 없는 상태를 묵시적 ERD 구조라고 부릅니다.
- 물리적 FK를 제거하는 실무적 이유:
- 성능 저하 및 데드락 방지: 데이터가 삽입/수정/삭제될 때마다 DB 엔진이 상위 부모 테이블의 정합성을 매번 물리적으로 체크하고 관련 행에 공유 락(Shared Lock)을 걸기 때문에 트래픽 폭주 시 급격한 성능 저하와 데드락의 원인이 됩니다.
- 운영 및 마이그레이션 편의성: 대규모 시스템 변경이나 데이터 이관(Migration) 시 물리적 FK 제약이 빡빡하게 걸려 있으면 데이터 정돈 순서가 꼬여 작업이 불가능해지는 경우가 많습니다.
- 실무적 대안: 관계 제약조건 검증은 어플리케이션 레이어(Spring Boot 비즈니스 로직 등)에서 코드로 검증하며 처리하고, 데이터베이스단에는 제약조건 없이 조인에 필요한 인덱스만 수동으로 생성하여 성능과 유연성을 동시에 챙기는 전략을 취합니다.
4. [참고] 정규화(Normalization)
1) 정규화의 정의
정규화는 관계형 데이터베이스 설계에서 데이터의 중복을 최소화하고 무결성을 극대화하기 위해 테이블을 구조화하는 프로세스입니다. 하나의 거대한 테이블을 상호 연관성이 있는 작은 테이블들로 분할해 나가는 과정이며, 비즈니스 규칙에 따른 함수적 종속성을 기반으로 수행됩니다.
2) 정규화를 통해 얻는 이점
- 데이터 이상 현상(Anomaly) 방지: 데이터 삽입, 수정, 삭제 시 발생할 수 있는 논리적 오류와 꼬임 현상을 근본적으로 차단합니다.
- 데이터 정합성 및 무결성 유지: 동일한 데이터가 여러 곳에 중복 저장되지 않으므로, 데이터의 일관성을 쉽게 보장할 수 있습니다.
- 저장 공간의 효율화: 중복 데이터 제거와 가변 길이 컬럼의 분리로 물리적 저장 공간을 절약합니다.
- 구조적 유연성 확보: 새로운 비즈니스 요구사항이나 테이블 컬럼이 추가될 때, 기존 구조를 크게 뒤흔들지 않고 확장할 수 있습니다.
3) 정규화의 종류 및 고려할 점
실무 및 엔터프라이즈 설계에서는 대개 1정규형부터 3정규형 또는 BCNF까지를 필수 단계로 다룹니다.
(1) 제1정규형 (1NF): 도메인 원자값 확보
- 핵심 의미: 테이블의 모든 컬럼은 단 하나의 값(원자값)만 가져야 합니다. 하나의 칸에 콤마(,)로 구분된 다중 값이나 배열 형태가 들어올 수 없습니다.
- 고려할 점: 다중 값을 분리하기 위해 행(Row)을 늘릴지, 아니면 별도의 자식 테이블로 격리할지 결정해야 합니다. 대량의 텍스트를 파싱하는 비용을 줄이기 위한 필수 단계입니다.
(2) 제2정규형 (2NF): 부분 함수 종속성 제거
- 핵심 의미: 제1정규형을 만족하고, 기본키(PK)가 2개 이상으로 구성된 복합키일 때 발생합니다. 기본키의 일부분에만 종속되는 컬럼(부분 함수 종속)이 있다면 이를 별도 테이블로 분리해야 합니다.
- 고려할 점: 복합키를 사용하는 매핑 테이블이나 이력 테이블에서 주로 검토됩니다. 만약 기본키가 단일 컬럼(예: 자동 증가 ID) 구조라면 제2정규형은 자동으로 만족하게 됩니다.
(3) 제3정규형 (3NF): 이행적 함수 종속성 제거
- 핵심 의미: 제2정규형을 만족하고, 기본키가 아닌 일반 컬럼들 간에 종속 관계가 존재해서는 안 됩니다. 즉, A가 B를 결정하고 B가 C를 결정하는 관계(A → B → C)가 있다면, A와 B, B와 C를 별도 테이블로 분리합니다.
- 고려할 점: 실무에서 가장 흔히 발생하는 중복 패턴입니다. 예를 들어 주문 테이블에 '우편번호'와 '기본주소'가 함께 있다면, 주소 정보는 우편번호 테이블로 독립시키는 것이 맞습니다. 다만, 분리 시 조인(JOIN) 횟수가 늘어나는 시점이므로 성능 측정을 동반해야 합니다.
(4) 보이스-코드 정규형 (BCNF): 결정자이면서 후보키가 아닌 것 제거
- 핵심 의미: 제3정규형을 강화한 버전으로, 테이블의 모든 결정자가 반드시 후보키(Candidate Key)여야 합니다. 복합키 구조에서 일반 컬럼이 복합키의 일부를 결정하는 특수한 경우를 해결합니다.
- 고려할 점: 규칙이 매우 엄격하므로 BCNF를 강제하다 보면 오히려 테이블이 과도하게 쪼개져 쿼리 제어 난이도가 급상승할 수 있습니다.
4) 비정규화(Denormalization / 역정규화)란?
비정규화는 정규화를 거쳐 완벽하게 분리된 데이터베이스 아키텍처에서, 시스템의 조회(Read) 성능을 극대화하기 위해 의도적으로 데이터의 중복을 허용하거나 테이블을 다시 병합하는 최적화 기법입니다. 정규화 규칙을 몰라서 무작정 짜는 형태와 달리, 철저히 정규화된 상태를 바탕으로 트래픽 병목을 해결하기 위해 수행하는 역방향 설계입니다.
5) 실무에서의 정규화 vs 비정규화 트레이드오프(Trade-off)
현대 백엔드 개발 및 데이터베이스 모델링은 이 두 개념의 팽팽한 줄다리기 속에서 최적의 균형점을 찾는 과정입니다.
6) 실무적인 절충안과 설계 가이드
현대 대규모 트래픽 환경에서는 무조건적인 정규화나 무분별한 비정규화 모두 장애의 원인이 됩니다. 따라서 다음과 같은 단계적 전략을 취합니다.
-
선(先) 정규화, 후(後) 비정규화 원칙: 최초 설계 단계에서는 데이터 정합성을 위해 3정규형 수준까지 철저하게 분리합니다.
-
조회 병목 구간 탐색: 시스템 운영 중 특정 어드민 대시보드나 메인 화면 쿼리에서 다중 조인으로 인해 응답 속도가 떨어지는 병목을 모니터링(APM 툴, Slow Log 등)합니다.
- 제한적 비정규화 기법 적용:
-
컬럼 중복: 주문 목록을 보여줄 때 매번 회원 테이블을 조인하지 않도록, 주문 테이블에 '회원명' 컬럼을 중복하여 들고 있게 합니다.
-
파생/통계 컬럼 추가: 특정 게시글의 댓글 수를 조회하기 위해 매번 COUNT() 쿼리를 날리지 않고, 게시글 테이블에
reply_count컬럼을 두고 댓글이 달릴 때마다 +1 해주는 방식을 씁니다. -
NoSQL 캐싱 기술과의 융합: RDBMS 자체를 비정규화하면 정합성 리스크가 너무 크기 때문에, 최근 아키텍처에서는 RDBMS는 정규화 상태를 유지하고 비정규화된 조회 전용 데이터는 Redis나 Elasticsearch 같은 외부 저장소로 이관하여 해결하는 폴리글랏 퍼시스턴스 방식으로 보완합니다.
댓글
GitHub 계정으로 의견이나 질문을 남길 수 있습니다.