페이지 불러오는 중
개인 프로젝트 RAG 세팅 : Andrej Karpathy가 제안한 LLM Wiki
목차
1. 개인 프로젝트와 AI 에이전트 활용의 한계
AI 에이전트 도입 초기 경험: 높은 생산성과 도구에 대한 신뢰 형성
개인 프로젝트를 시작할 때 AI 에이전트를 활용하면 상상 이상의 생산성을 체감하게 됩니다. 프로젝트 초기 단계에서는 보일러플레이트 코드 작성, 기본 API 엔드포인트 설계, 간단한 컴포넌트 생성 등 일반적인 범위의 작업이 주를 이룹니다. 이 시기 AI 에이전트는 작성자의 의도를 완벽히 이해하는 듯한 뛰어난 답변을 제공하며, 개발 속도를 2배, 3배 이상 끌어올려 줍니다. 개발자는 자연스럽게 도구에 대한 깊은 신뢰를 형성하고 AI 중심의 개발 프로세스를 구축하게 됩니다.
프로젝트 고도화 단계의 병목: 세부 영역 요청 시 맥락 이탈 및 품질 저하
하지만 프로젝트가 점차 진척되고 시스템 모듈 간의 의존성이 복잡해질수록 예상치 못한 병목 현상이 발생합니다. 특정 도메인 로직을 정교하게 수정하거나, 좁은 영역의 에지 케이스를 처리해 달라고 요청할 때 AI의 성능이 급격히 저하되는 현상을 경험합니다. AI는 기존 코드베이스 전체의 세부적인 맥락을 제대로 파악하지 못한 채 환각(Hallucination)을 일으키거나, 이전 질문과 배치되는 수정을 제안하고, 심지어 이미 잘 작성된 다른 기능을 파괴하기도 합니다. 결과적으로 입력한 프롬프트 대비 출력물의 품질이 떨어져 사람이 직접 코드를 복구하고 수정해야 하는 상황이 빈번해집니다.
기존 RAG(Retrieval-Augmented Generation)의 근본적 한계: 단편적 조각 검색과 지식의 휘발성
이러한 맥락 손실 문제를 해결하기 위해 대다수의 개발자는 벡터 DB 기반의 RAG(검색 증강 생성) 시스템을 도입하곤 합니다. 하지만 기존 RAG 시스템에도 근본적인 한계가 존재합니다. 기존 RAG는 질문이 들어오는 검색 시점(Query-time)에 문서를 임의의 크기(Chunk)로 쪼개어 유사도가 높은 파편화된 조각만 가져옵니다.
이 방식은 질의응답 당시에는 유용해 보일 수 있으나, 전체적인 시스템 구조나 문서 간의 유기적인 관계를 반영하지 못합니다. 또한 질문이 끝날 때마다 생성된 통찰이 시스템에 저장되지 않고 휘발되므로, 매번 유사한 조각을 새로 찾아 합성해야 하는 무상태성(Stateless)의 한계에 부딪히게 됩니다.
2. Andrej Karpathy의 LLM Wiki 개념 이해
LLM Wiki 정의: '단순 검색'에서 '지식 컴파일'로의 패러다임 전환
2026년 초, 안드레이 카파시(Andrej Karpathy)는 기존 RAG의 한계를 극복하기 위해 'LLM Wiki'라는 지식 관리 패러다임을 제안했습니다. LLM Wiki는 단순한 문서 검색기 역할에 머무르던 AI를 '지식 컴파일러'이자 '위키 편집자'로 확장하는 접근법입니다. 정보를 필요할 때마다 사후적으로 찾아 헤매는 것이 아니라, 자료가 수입(Ingest)되는 시점에 AI가 이를 직접 가공하고 정리하여 거대한 마크다운 위키 형태로 컴파일해 두는 방식입니다.
핵심 아이디어: AI가 지속적으로 편집하고 연결하는 영속적 마크다운 지식베이스
LLM Wiki의 핵심은 인간이 위키를 직접 작성하는 것이 아니라, AI 에이전트가 주도적으로 위키를 생성, 수정, 업데이트한다는 점입니다. 새로운 기술 문서, 회의록, 코드 변경 사항, 도메인 지식이 들어오면 AI는 이를 분석하여 기존 위키 페이지들과의 관계를 파악합니다. 그리고 개념 페이지, 요약 문서, 비교 분석 페이지 등을 새로 작성하거나 기존 문서를 수정하고, 문서 간 위키 링크([[문서명]])를 연결해 영속적인 지식 저장소를 구축합니다.
인간과 AI의 역할 분담: 인간(출처 제공 및 질의), AI(위키 구조화, 링크 연결, 일관성 유지)
LLM Wiki 체계에서 인간과 AI의 역할은 명확하게 분리됩니다.
- 인간의 역할: 신뢰할 수 있는 원시 출처(Raw Source)를 제공하고, 적절한 탐색 질문을 던지며, AI가 가공해 둔 위키 결과를 읽고 검토하는 감독관 역할을 수행합니다.
- AI의 역할: 전달받은 원시 자료에서 핵심 개념을 추출하고, 체계적인 구조로 위키 문서를 작성하며, 문서 간 상호 참조를 관리하고 모순되는 지식을 정리하는 편집자 역할을 담당합니다.
3. LLM Wiki의 핵심 아키텍처 및 동작 방식
3계층 구조: 원시 자료(Raw Sources) -> 컴파일된 위키(Wiki Pages) -> 질의 인터페이스(Query Agent)
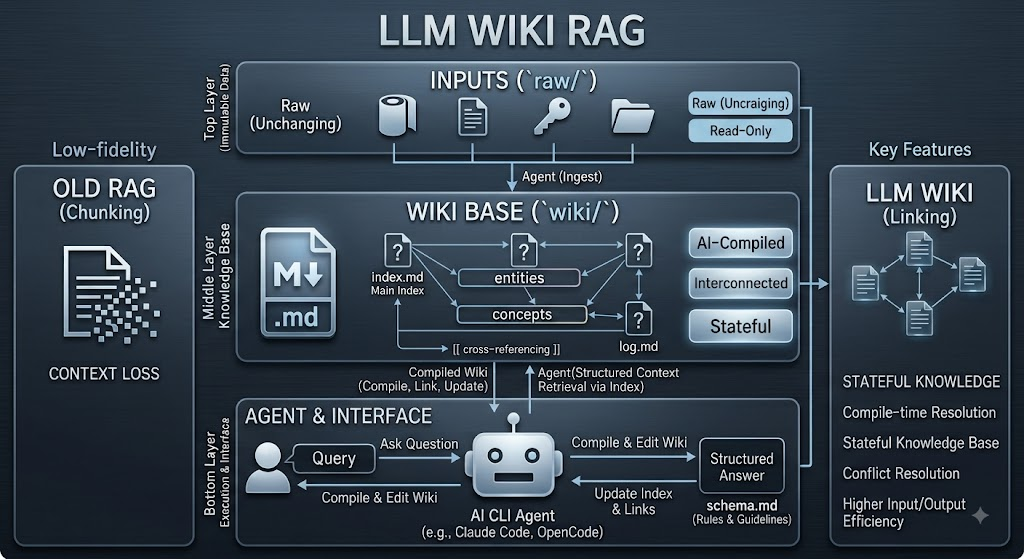
LLM Wiki는 명확하게 분리된 3계층 아키텍처를 기반으로 작동합니다.
- 원시 자료 계층 (Raw Sources Layer /
raw/)
- 수집된 외부 기사, 기술 명세서, 회의록, 개인 메모 등의 불변(Immutable) 원본 데이터입니다.
- 원본 보존을 위해 AI가 함부로 수정하지 않고 읽기 전용 상태를 유지합니다.
- 컴파일된 위키 계층 (Wiki Layer /
wiki/)
- AI 에이전트가 원시 자료를 바탕으로 작성하고 지속적으로 업데이트하는 마크다운 파일들의 집합입니다.
- 개별 엔티티, 주요 개념, 비교 분석, 핵심 요약 및 전체 인덱스(Index) 페이지가 포함됩니다.
- 규약 및 질의 계층 (Schema & Agent Layer /
schema.md, CLI)
- AI 에이전트가 위키를 작성하고 업데이트할 때 준수해야 하는 규칙(프롬프트 스키마)과 사용자와의 소통 인터페이스입니다.
- 문서 작성 포맷, 인용 규칙, Lint 체크 기준, 링크 생성 방식 등이 정의됩니다.
상호 참조(Cross-referencing)와 색인을 통한 문맥 유지
위키의 강점은 문서와 문서가 연결되어 있다는 점입니다. AI 에이전트는 새로운 정보를 위키에 편입시킬 때 단일 문서 생성에 그치지 않고, 관련된 기존 개념 문서들을 찾아 하이퍼링크로 연결합니다. central index 페이지와 커밋 로그(Activity Log)를 상시 갱신하여 시스템 전체의 맥락 파악 경로를 최단거리로 유지합니다. 이로 인해 세부 작업 요청 시 에이전트가 인덱스와 연관 위키 문서를 참조함으로써 맥락 손실을 최소화할 수 있습니다.
지식의 복리(Compounding) 효과: 데이터가 쌓일수록 견고해지는 프로젝트 맥락
RAG가 질문마다 처음부터 검색을 반복하는 것에 비해, LLM Wiki는 소스가 추가될수록 지식의 밀도가 높아집니다. 기존 지식과 새로운 지식 간의 충돌이 발생하면 AI가 이를 감지하여 모순점을 별도로 기록하거나 업데이트합니다. 데이터가 축적될수록 위키 전체의 연결성이 강화되어 프로젝트 고도화 단계에서도 정밀한 답변을 출력하는 지식의 복리 효과가 나타납니다.
4. 개인 프로젝트를 위한 LLM Wiki 실전 구축 가이드
작업 환경 세팅: 마크다운 에디터(Obsidian 등) + 터미널 에이전트(Claude Code 등)
개인 개발자가 LLM Wiki를 구축하는 가장 이상적인 조합은 마크다운 기반의 로컬 에디터와 터미널 에이전트를 연동하는 것입니다.
- 마크다운 IDE (Obsidian): 문서 간의 연결 그래프 visualizer, 빠른 검색, 마크다운 렌더링 환경을 제공합니다.
- AI CLI 에이전트 (Claude Code, OpenCode 등): 파일 시스템에 직접 접근하여 마크다운 문서를 읽고, 생성하고, 업데이트할 수 있는 터미널 기반 에이전트를 사용합니다. 한쪽에 옵시디언을 띄워두고 다른 한쪽에 터미널 에이전트를 실행하여, AI가 실시간으로 위키 코드를 수정하면 옵시디언 그래프와 문서에 즉시 반영되는 환경을 구성합니다.
폴더 구조 설계 및 노트 표준 템플릿(요약, 태그, 관련 문서) 정의
효율적인 관리를 위해 다음과 같은 로컬 디렉터리 구조를 설계합니다.
text
my-project-wiki/
├── raw/                  # 변경되지 않는 원시 출처 (PDF, txt, md 등)
├── wiki/                 # LLM이 작성하고 관리하는 마크다운 위키
│   ├── index.md          # 전체 위키 목차 및 메인 색인
│   ├── log.md            # 지식 변경 및 업데이트 이력 Log
│   ├── entities/         # 주요 객체, 모듈, 인물 등
│   └── concepts/         # 주요 개념, 설계 패턴, 도메인 지식
└── schema.md             # LLM 에이전트 작업 지침서 및 운영 규칙
AI가 문서를 생성할 때 표준성을 유지하도록 schema.md에 다음과 같은 Frontmatter 포맷을 정의해 둡니다.
markdown
---
title: "문서 제목"
type: "concept | entity | summary"
created: YYYY-MM-DD
updated: YYYY-MM-DD
sources: ["[[raw_source_1.md]]"]
tags: [tag1, tag2]
---

# 문서 제목

## 개요
...

## 핵심 내용
...

## 관련 문서
* [[관련_문서_1]]
* [[관련_문서_2]]
AI 에이전트를 활용한 문서 수집, 지식 병합, 충돌 관리 워크플로우
- 수집 (Ingest): 새로운 도메인 문서나 기획 내용이 들어오면
raw/폴더에 위치시킨 후 에이전트에 "새 원시 자료를 기반으로 위키를 업데이트해줘"라고 명령합니다. - 컴파일 및 병합 (Compile & Merge): 에이전트는 원문 요약 노트를 만들고, 기존
wiki/concepts/및wiki/entities/문서 중 연관된 항목을 찾아 내용을 추가/수정합니다. - 충돌 관리 (Contradiction Resolution): 기존 설계와 변경된 내용 간의 모순이 발견되면 에이전트가 "설계 변경 사항"을 명시하고 업데이트 로그에 남깁니다.
5. 기존 RAG vs LLM Wiki 비교 분석
검색 시점(Query-time) 처리 vs 컴파일 시점(Compile-time) 처리
기존 RAG는 질문이 던져진 후 데이터베이스를 뒤지는 구조이므로, 매번 읽기 연산 비용이 크고 문맥 복원력이 낮습니다. 반면 LLM Wiki는 소프트웨어 빌드 과정처럼 '컴파일'을 사전에 마치므로 질의 시점에는 완벽하게 정리된 지식만 빠르게 읽어 들여 답변 품질이 비약적으로 향상됩니다.
조각난 텍스트 참조 vs 맥락이 보존된 상호 연결 문서 참조
문장이나 단락 단위로 잘린 텍스트 조각은 시스템 전체 설계나 모듈 간 연관 관계를 표현하기 어렵습니다. LLM Wiki는 마크다운 문서 구조와 위키 링크를 사용하므로, AI 에이전트가 정보 간의 연결 고리를 파악한 상태에서 정교하게 작업을 수행합니다.
AI 에이전트 통제력 및 입력 대비 출력(Input/Output) 효율성 비교
RAG 환경에서는 질문 프롬프트를 상세하게 작성하더라도 에이전트가 엉뚱한 맥락을 잡아 출력이 왜곡되기 쉽습니다. LLM Wiki를 활용하면 이미 검증되고 구조화된 문서 집합 내에서 에이전트가 움직이므로, 작은 입력(Prompt)으로도 의도한 방향의 정확한 출력(Output)을 얻을 수 있습니다.
6. 결론 및 적용 소감
프로젝트 세부 영역 작업 시 AI 통제력 확보 가능성
안드레이 카파시가 제안한 LLM Wiki는 "AI 에이전트를 어떻게 제어할 것인가?"에 대한 명쾌한 답을 제시합니다. 프로젝트 초기에는 기존 AI 활용법으로도 충분할 수 있지만, 시스템이 고도화되고 세부 영역에 대한 정밀한 작업이 요구될 때는 지식을 사전에 체계화하는 LLM Wiki 접근법이 필수적입니다. 지식의 영속성과 연결성을 확보함으로써 AI 에이전트의 환각을 방지하고 작업 정확도를 대폭 끌어올릴 수 있습니다.
개인 개발 프로세스 및 지식 관리 파이프라인의 향후 발전 방향
단순히 코딩 도구로써 AI를 쓰는 시대를 지나, AI가 직접 내 개인 프로젝트의 지식베이스를 관리하고 축적하는 파이프라인을 구축하는 것은 개인 개발자의 경쟁력을 크게 높여줍니다. 앞으로의 개인 개발 프로세스는 '코드를 직접 작성하는 시간'보다 'AI가 관리하는 지식 위키의 품질을 감독하고 정밀한 요구사항을 전달하는 방향'으로 발전할 것입니다. LLM Wiki는 이러한 개발 패러다임의 변화를 선도하는 훌륭한 프레임워크입니다.
*참고문헌
- Andrej Karpathy - LLM Wiki (GitHub Gist) - https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- Beyond RAG: How Andrej Karpathy's LLM Wiki Pattern Builds Knowledge That Actually Compounds - https://levelup.gitconnected.com/beyond-rag-how-andrej-karpathys-llm-wiki-pattern-builds-knowledge-that-actually-compounds-31a08528665e
- LLM Wiki Setup: Karpathy's Knowledge Base [2026 Guide] - https://www.kunalganglani.com/blog/llm-wiki-karpathy-local-knowledge-base
- Where RAG Breaks Down: The Karpathy LLM Wiki Alternative - https://www.mindstudio.ai/blog/karpathy-llm-wiki-pattern-knowledge-base-without-rag
- Karpathy's LLM Wiki: Beyond RAG - https://noqta.tn/en/blog/karpathy-llm-wiki-knowledge-base-beyond-rag-2026
댓글
GitHub 계정으로 의견이나 질문을 남길 수 있습니다.